Usługi 01
Fundamenty danych pod AI
AI jest tak dobre jak dane pod nim. Łączymy rozproszone źródła, uzgadniamy definicje i budujemy platformy, które przetwarzają dane szybciej i taniej, żeby analityka i modele miały na czym stać.
Kiedy to ma sens
- Dane istnieją, ale leżą w tysiącach arkuszy, osobnych systemach albo niepowiązanych plikach.
- Dwa raporty pokazują różne liczby dla tej samej miary i nikt nie wie, który ma rację.
- Koszty platformy danych rosną, licencje są drogie albo platforma jest za wolna dla modeli.
- Dane muszą zostać w Waszym data center, czasem w ogóle bez dostępu do internetu.
Co macie na końcu
- Jedną platformę z udokumentowanymi źródłami, definicjami i pochodzeniem danych.
- Zmierzony czas przetwarzania i koszt utrzymania, przed i po.
- Fundament gotowy na pierwszy przypadek użycia AI, z potrzebnymi danymi na miejscu.






Co robimy
- 01
Łączymy źródła i nadajemy im kontekst
Zdjęcia, wyniki laboratorium, dane z maszyn i systemów powiązane ze stanowiskiem, produktem albo klientem, do którego należą. Jedno wspólne źródło zamiast wielu kopii.
- 02
Definicje, jakość i pochodzenie danych
Uzgadniamy definicje miar, ustawiamy kontrole jakości i pokazujemy, skąd bierze się każda liczba, żeby analityk i asystent AI mogli wskazać źródło.
- 03
Modernizacja platformy
Spark na Kubernetes, Trino, magazyn obiektowy. Migrujemy etapami i porównujemy wyniki przed każdym przełączeniem, z planem powrotu.
- 04
Wydajność i koszty
Stroimy odczyt danych, partycjonowanie, wymianę danych między procesami i zapytania. W projekcie dla telekomunikacji samo to dało dwukrotnie szybsze przetwarzanie.
- 05
Potoki gotowe na ML
Potoki cech, śledzenie modeli w MLflow i wspólne fundamenty dla analityki i uczenia maszynowego.
Na początek
Powiązane case studies
Platforma danych operatora: 2× szybciej, 60% niższe koszty operacyjne
Firma telekomunikacyjna · Telekomunikacja
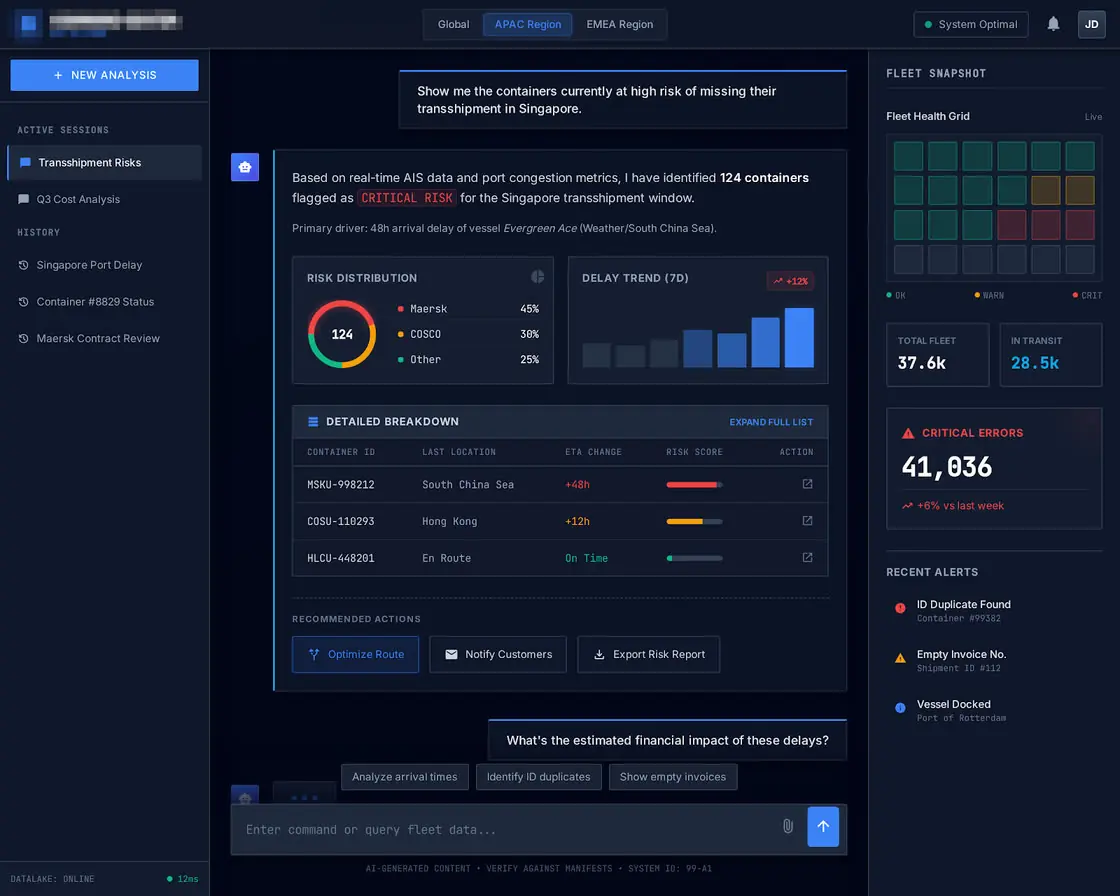
Wieża kontroli logistyki: 37,6 tys. kontenerów w czasie rzeczywistym
Globalny operator logistyczny, ponad 30 tys. aktywnych kontenerów · Logistyka
Platforma danych dla zdrowia psychicznego: 30× więcej danych, codziennie
Firma z obszaru cyfrowego zdrowia psychicznego · Ochrona zdrowia
Pytania, które zadają kupujący
Czy musimy przejść do chmury?
Nie. Budujemy w Waszym data center, w chmurze albo hybrydowo. W projekcie dla operatora telekomunikacyjnego wszystko działało on-premise, bez dostępu do internetu.
Czy przeniesiecie nas z Cloudera albo Hadoopa?
Tak. Zmodernizowaliśmy platformę operatora telekomunikacyjnego wykonującą 900 tys. zadań tygodniowo na Cloudera, przebudowując ją na Spark i Trino: dwa razy szybciej, 60% niższe koszty operacyjne i koniec opłat licencyjnych za Cloudera.
Jak nie zepsuć raportów podczas migracji?
Migrujemy etapami i uruchamiamy starą i nową platformę równolegle, porównując wyniki zadanie po zadaniu przed każdym przełączeniem. Każdy etap ma plan powrotu.
Ile to kosztuje?
Zacznijcie od przeglądu kosztów platformy danych albo diagnozy gotowości AI; obie oferty mają stały zakres i cenę „od” na swoich stronach. Cały projekt wyceniamy potem, z uzasadnieniem każdej pozycji.
Porozmawiajmy o Waszym projekcie
Opiszcie swój przypadek
Wybierzcie jeden problem.
Pokażcie dostępne dane.
Ustalmy mierzalny cel.
Wskażcie proces i dane, które macie. Odezwie się inżynier, nie call center.
Odpowiadamy w ciągu jednego dnia roboczego.